FITradeoff: o mesmo método, com uma stack de hoje
Resumo executivo
- Por que existe: o sistema oficial do método funciona, mas é antigo. Feito em Delphi, ele às vezes trava ou sai do ar e não usa HTTPS. Quis mostrar que uma stack de hoje faz o mesmo de um jeito mais robusto, mais confiável e mais bonito.
- O que é: uma implementação independente do FITradeoff, que apoia decisões com vários critérios sem pedir pesos, só com perguntas de troca.
- O que não é: um substituto do oficial. Sem acesso ao motor original, reconstruí o comportamento dele por engenharia reversa.
- Stack: Python com o solver HiGHS, FastAPI, Next.js e um servidor MCP, tudo em Docker.
- Qualidade: cerca de 1.675 testes, e resultado e sequência de perguntas iguais aos do oficial em 67 de 73 casos comparáveis.
- Tempo e custo: cerca de 60 horas, metade delas na engenharia reversa, e cerca de US$ 1.600 a preço de API. Não foi o que eu gastei, porque usei um plano de assinatura.
- Situação: o FITradeoff saiu do ar, e o código está no GitHub.
O resumo te interessou? Então siga em frente, o resto é para você. Se não interessou, pode parar por aqui sem culpa: o essencial está aí em cima, e o seu tempo vale mais do que o meu texto.
Quanto isso custou, em horas e em tokens
Todo o FITradeoff foi construído com o Claude Code, que registra o horário de cada mensagem e os tokens gastos em cada resposta. Com esses registros, medi o tempo e o custo do projeto.
O valor em dólar desta seção não foi o que eu gastei. Usei um plano de assinatura, bem mais barato. O número mostra quanto o mesmo trabalho custaria pagando a API da Anthropic por uso, e é o que mais se aproxima do custo real de construir algo assim com IA.
O tempo
Foram cerca de 60 horas de trabalho em 11 dias, com 256 pedidos. Dessas horas, entre 9 e 19 foram minhas, lendo respostas e escrevendo pedidos; no resto, o agente trabalhou sozinho. Contei só os trechos com atividade, sem as pausas acima de 10 minutos. Tolerando pausas de até 30 minutos, o total chega a cerca de 82 horas.
A engenharia reversa levou metade desse tempo, cerca de 34 horas, contra 8 da construção das funcionalidades. Para quem pensa em fazer algo parecido, é isso que eu levaria em conta no planejamento. Com um agente de código, implementar o que os artigos descrevem anda rápido, e o que demora é fazer o programa se comportar como um sistema que só se vê de fora. Aqui, foram umas quatro horas de comparação para cada hora de construção, num sistema de cinco módulos e 74 casos comparados. Não é uma regra, e num sistema maior ou menos documentado a comparação deve pesar ainda mais.
Onde foram o tempo e o dinheiro
Por tipo de trabalho, os pedidos se dividiram assim.
| O que eu estava pedindo | Pedidos | Tempo | Custo (API) |
|---|---|---|---|
| Comparação com o sistema oficial | 94 | ~34 h | US$ 641 |
| Refinos e correções, incluindo revisões de código | 55 | ~14 h | US$ 448 |
| Construção de funcionalidades | 41 | ~8 h | US$ 194 |
| Deploy, infraestrutura e segurança | 46 | ~7 h | US$ 187 |
| Documentação | 10 | ~2 h | US$ 59 |
| Ambiente e ferramentas | 6 | ~1 h | US$ 33 |
| Sem assunto definido | 4 | ~2 h | US$ 36 |
| Total | 256 | ~68 h | ≈ US$ 1.600 |
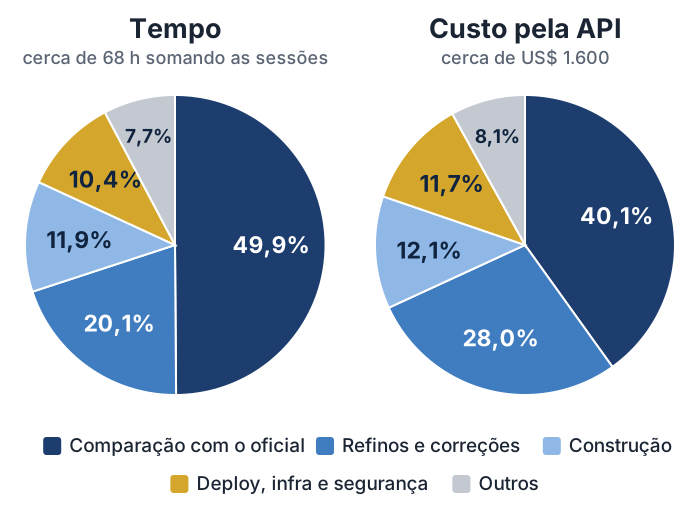
A comparação com o oficial ficou com metade do tempo e cerca de 40% do custo, quase o mesmo que construção e refinos somados. A seção "Os artigos não bastaram", mais abaixo, explica por quê.
Os tokens
Foram cerca de 3 bilhões de tokens, 98,7% deles de leitura de cache, porque a cada resposta o modelo relê a conversa inteira. Essa releitura custa uma fração do preço normal e, mesmo assim, ficou com cerca de 74% da conta. O texto que o modelo de fato escreveu, código incluído, somou só 6,5 milhões de tokens. Quase tudo rodou no Claude Opus 5 e no Opus 5.5.
Como cheguei nesses números
Os preços são os da tabela que o próprio Claude Code usa no comando /cost, a mesma da API (o Opus 5, por exemplo, custa US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de saída). Numa sessão completa, a minha conta ficou 4% abaixo da do Claude Code, então vale uma margem de uns 5%. A classificação dos pedidos foi feita à mão, e ficaram de fora as conversas no claude.ai e os pedidos de outros projetos.
Por que refazer algo que já existe
O FITradeoff já existia. O grupo que criou o método, no CDSID da UFPE, mantém um sistema oficial usado em pesquisa, e o mérito do método é todo dos autores. O que eu queria pôr à prova era a stack.
O sistema oficial é de outra geração de software. Feito em Delphi, com o framework IntraWeb, ele às vezes trava no meio de uma sessão, e durante os meus testes saiu do ar várias vezes, por horas. Ele é servido sem HTTPS, então o login e os dados das decisões trafegam sem criptografia. As telas existem só em inglês, com um aviso para não usar a tradução automática do navegador, e os critérios aparecem como C1, C2 e C3. Nada disso é defeito do método, e sim da época em que o software foi feito.
A pergunta, então, era se o mesmo método, construído com as ferramentas de hoje, viraria um programa mais robusto, mais confiável e mais bonito. Para a resposta valer, eu não podia mexer no método, e por isso nada era dado como pronto antes de passar pela comparação com o oficial.
O problema dos pesos
Em engenharia, é comum decidir entre alternativas avaliadas por vários critérios, e a ferramenta mais usada é a soma ponderada. O problema dela está nos pesos. É difícil afirmar, com segurança, que o custo vale 0,35 e o prazo 0,20, e muitas vezes esse número sai de um palpite do qual a conclusão inteira passa a depender.
O FITradeoff, proposto por Adiel de Almeida e colegas em 2016, troca a pergunta sobre pesos por comparações entre duas situações concretas, em unidades reais, e faz só as perguntas de que precisa.
Como o método funciona, sem fórmulas
A pessoa começa ordenando os critérios, do mais ao menos importante, o que já estreita o espaço de pesos possíveis. Depois vêm as perguntas de troca, em que o sistema mostra duas consequências hipotéticas e pergunta qual ela prefere. Por trás, cada resposta é um passo de uma busca binária sobre a razão entre dois pesos.
A cada resposta, o sistema verifica, com programação linear, quais alternativas ainda podem ser a melhor com algum conjunto de pesos compatível com tudo o que foi dito. Quando sobra uma só, ou quando as que sobram são praticamente equivalentes, as perguntas acabam. A implementação cobre as cinco problemáticas do oficial (escolha, ordenação, classificação, carteira e benefício por custo). A escolha é exata, e a carteira, aproximada.
Os artigos não bastaram
Comecei pelo artigo de 2016, pelo guia do usuário e por outros trabalhos do grupo. Eles explicam bem o método, mas não as regras que fazem o programa se comportar como se comporta, como a pergunta que abre a sessão, a ordem dos pares de critérios e o momento de parar. Sem essas regras, uma implementação fiel aos artigos pode chegar ao mesmo resultado por outro caminho, e então já não é o mesmo programa.
A saída foi engenharia reversa. Escrevi um robô com Playwright que roda os mesmos casos no oficial e na versão nova e compara pergunta por pergunta, e foi assim que as regras escondidas apareceram. Num critério discreto, como uma nota de 1 a 5, o oficial só pergunta no terço, no meio e nos dois terços entre dois níveis, enquanto a minha versão fazia uma busca contínua. Foram cinco rodadas até essa regra fechar.
O robô foi um projeto à parte, porque o oficial recusava navegador automatizado, tinha botões que sumiam no meio do clique e sessões que travavam por horas. Por isso, cada medição ficou gravada, e a suíte de paridade roda sem rede. Alguns pontos, como a fórmula do modelo de veto, não puderam ser confirmados e estão registrados como inferência.
As duas versões, lado a lado
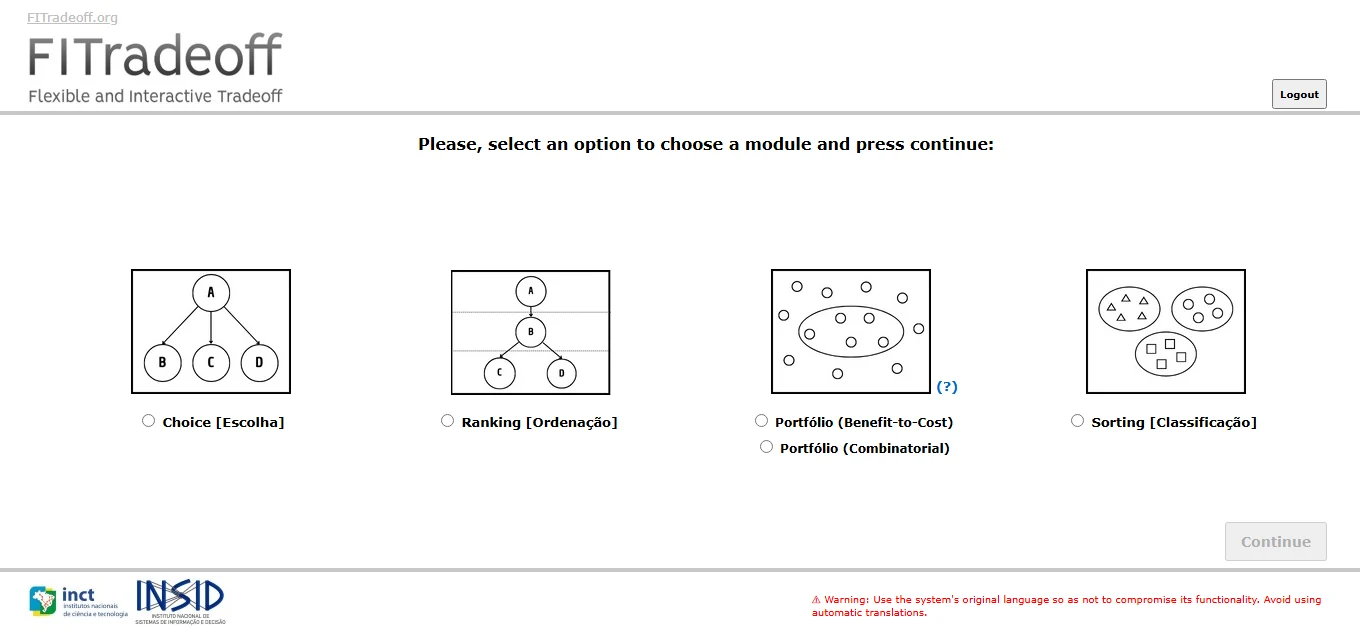
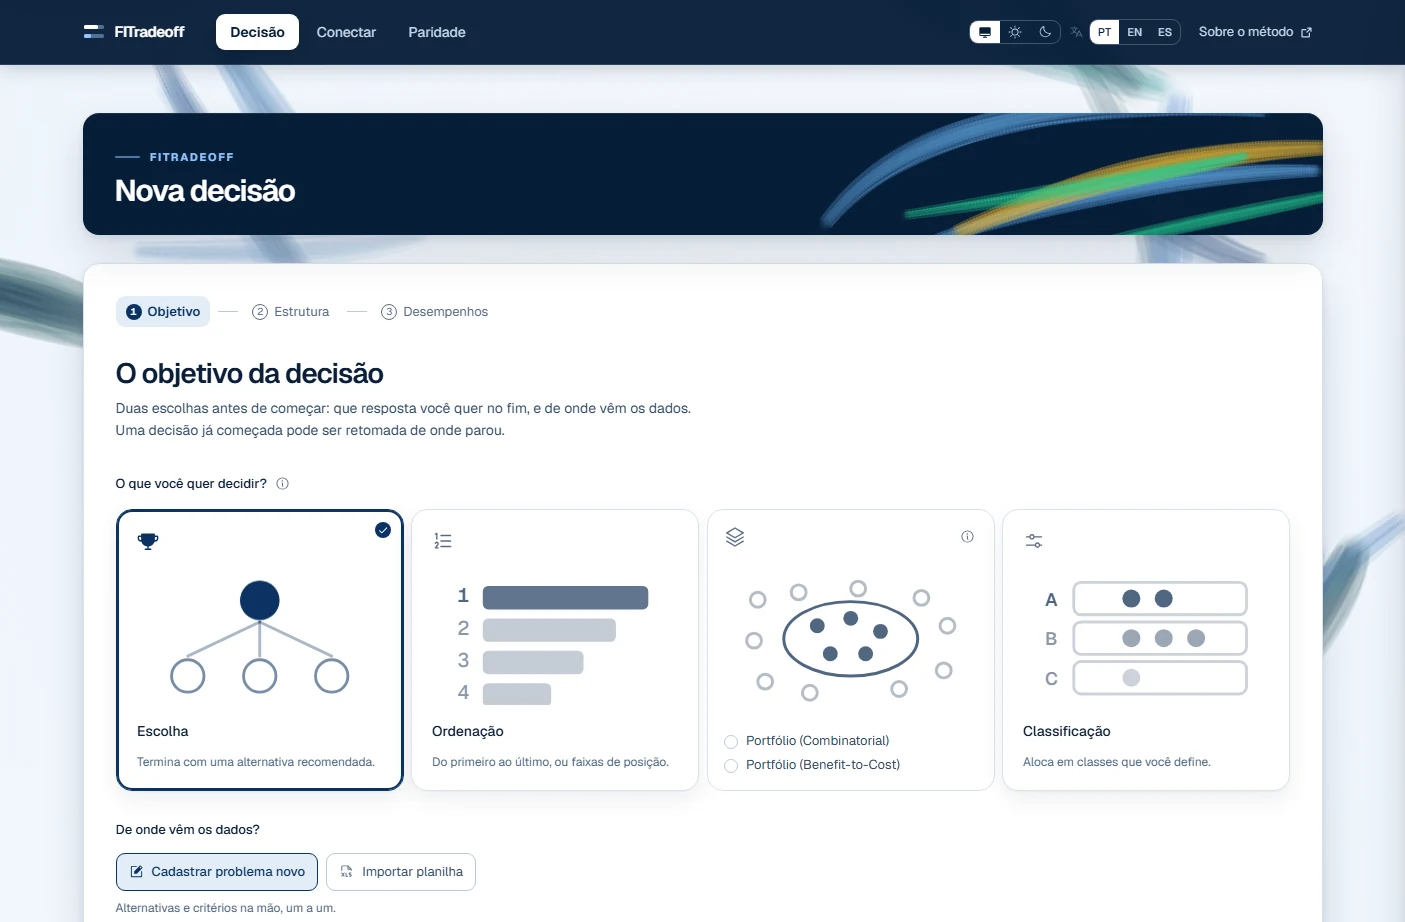
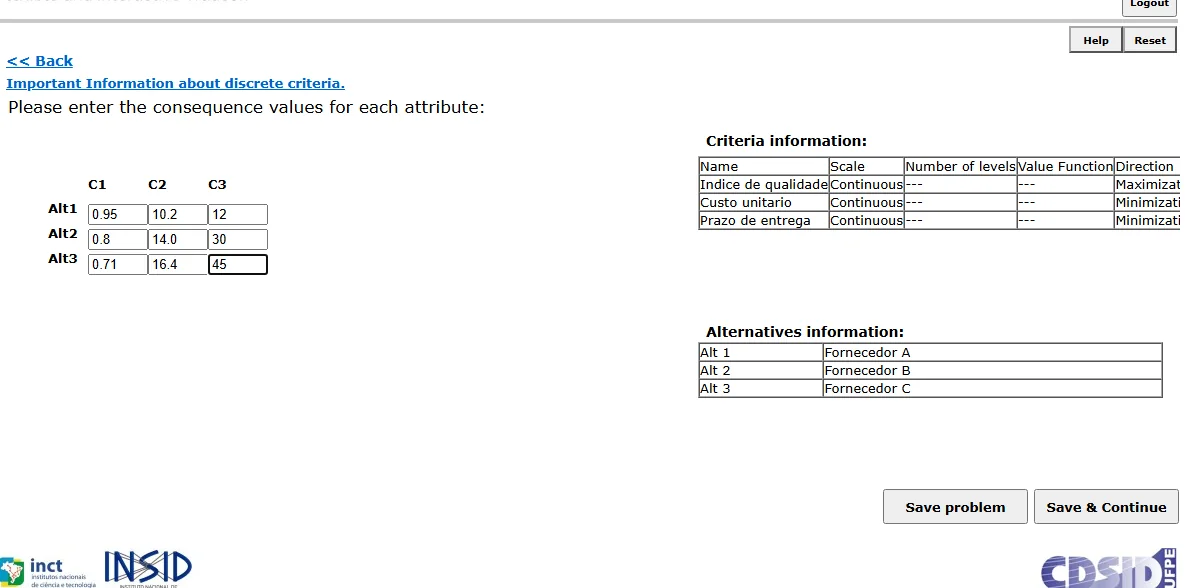
As imagens abaixo mostram as mesmas etapas nos dois sistemas, com o oficial em cima. As capturas do oficial são do FITradeoff.org, do CDSID/UFPE, e estão aqui só para comparação.
A tela inicial
As duas telas oferecem as mesmas opções, inclusive as duas variantes de portfólio. No oficial, os módulos aparecem com o nome em inglês e a tradução entre colchetes, e só o portfólio tem um botão de ajuda. Na versão nova, cada cartão diz em que aquela decisão termina, os passos seguintes aparecem no topo e a origem dos dados, à mão ou por planilha, é escolhida ali mesmo.
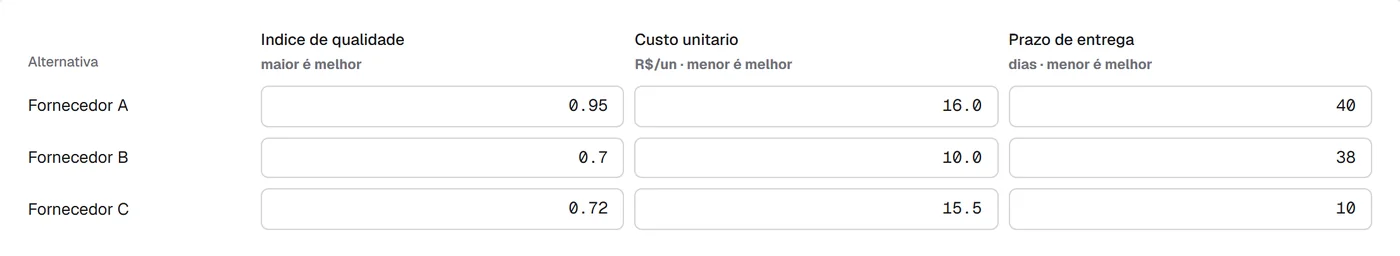
Matriz de desempenhos
Pergunta de troca
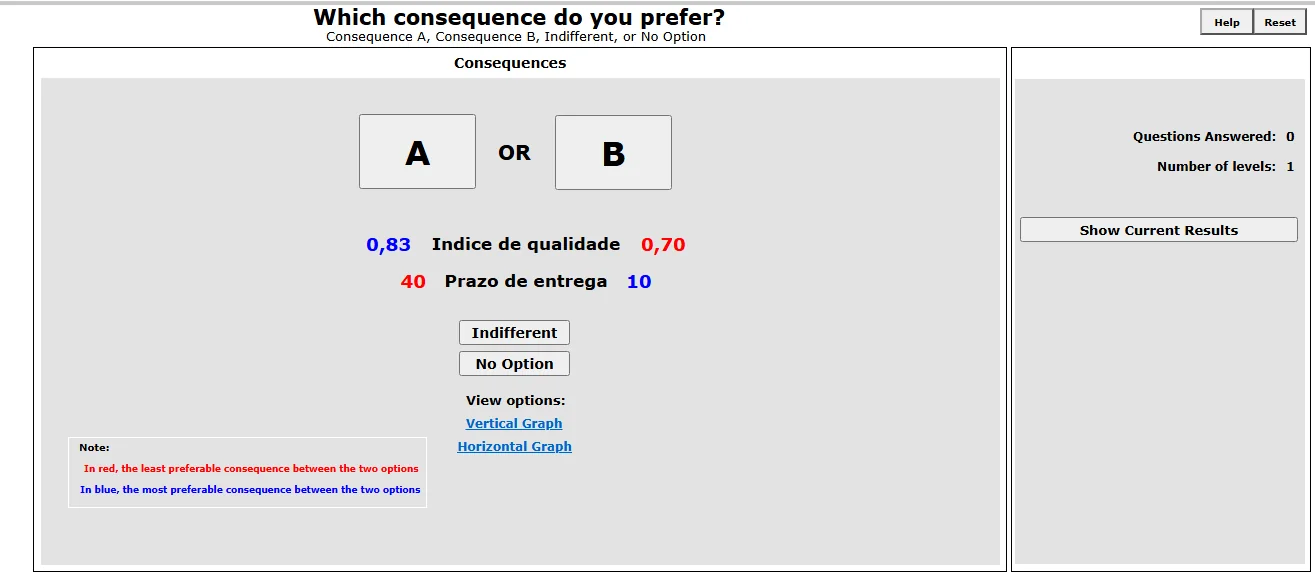
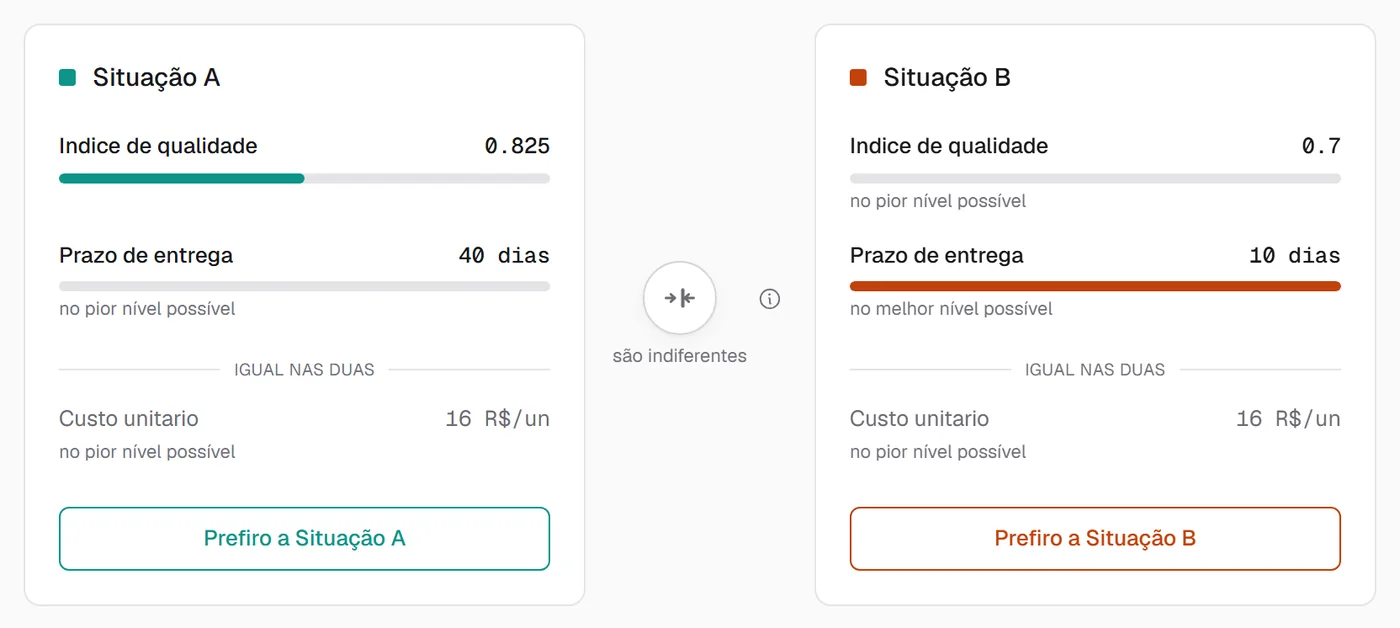
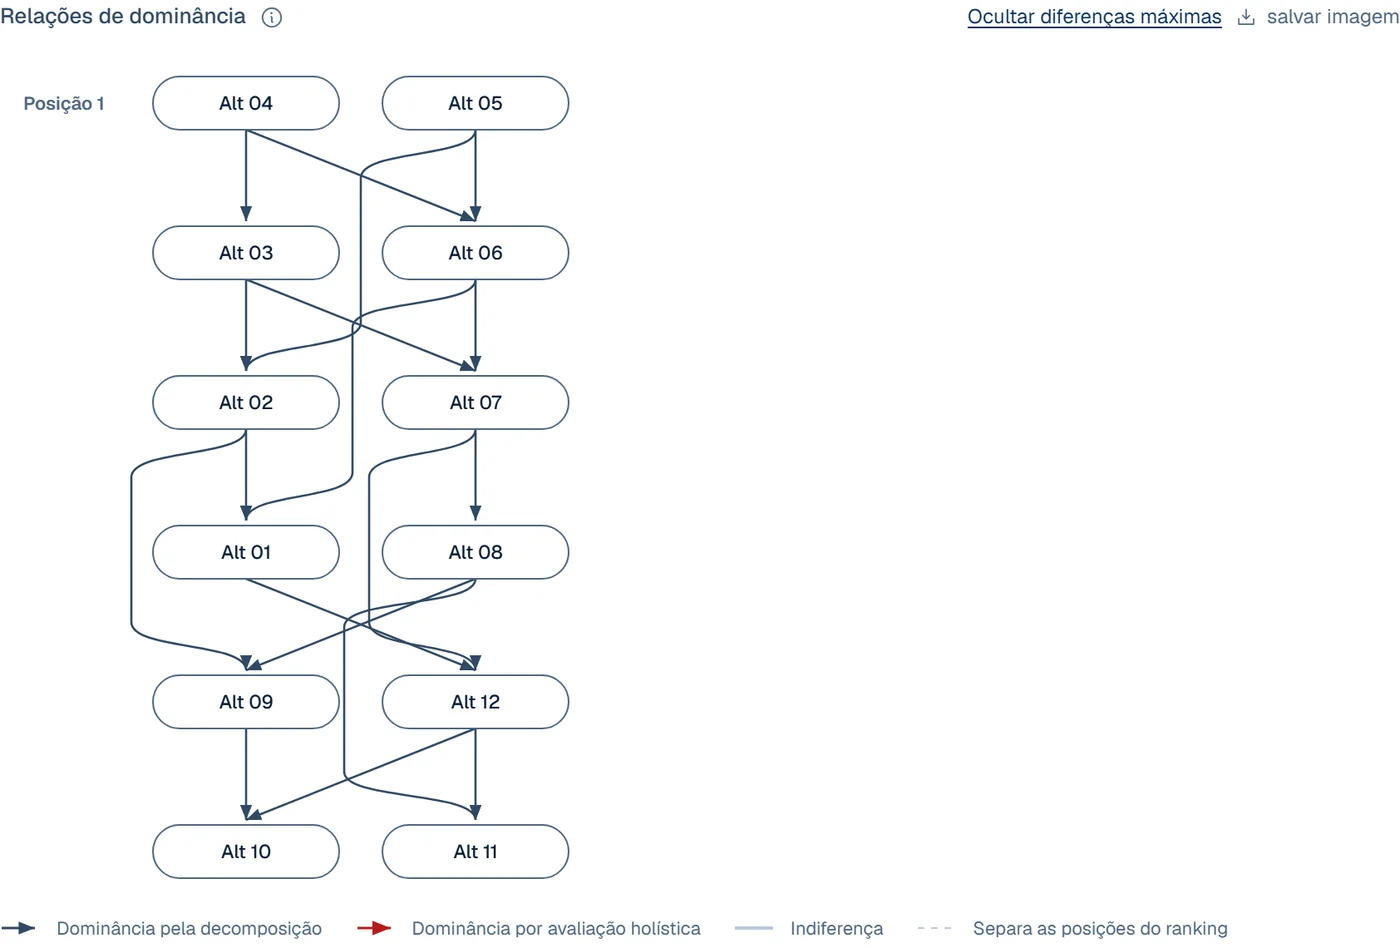
Diagrama de Hasse
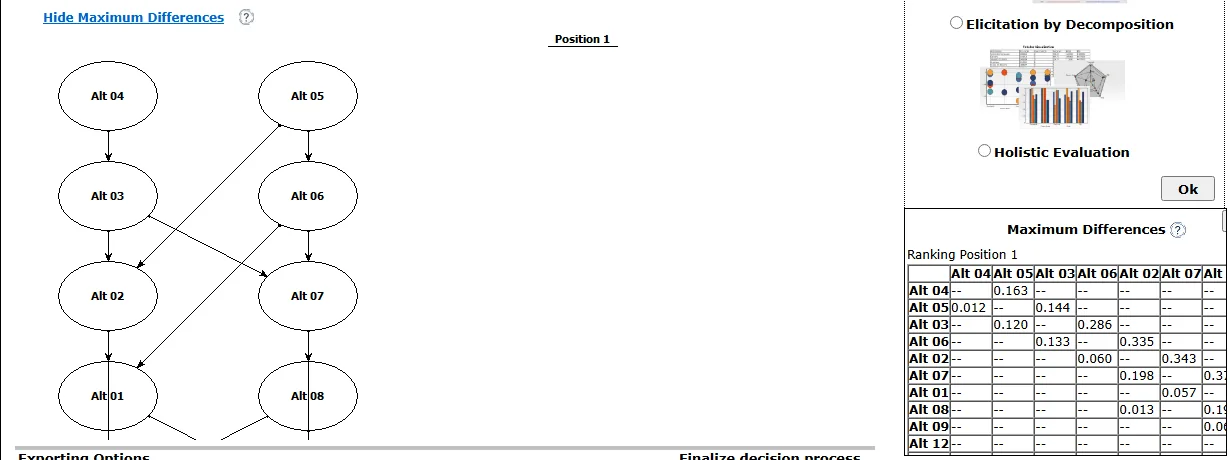
Quando a ordem ainda não fechou, os dois sistemas desenham quem nunca fica atrás de quem. No caso comparado, os pares de dominância saem iguais nos dois.
A stack
O repositório tem cinco partes: o motor (engine/), a API (api/), o servidor MCP (mcp_server/), a interface (web/) e a suíte de paridade (paridade/). O motor usa Python 3.13, NumPy, SciPy e o solver HiGHS, a API usa FastAPI e a interface usa Next.js 15, React 19, TypeScript e Tailwind. Tudo roda em containers Docker endurecidos, que reiniciam sozinhos, atrás de um Caddy com HTTPS, e o deploy pelo GitHub Actions volta à versão anterior se a subida falhar. Um teste ainda lê o código do motor e falha se uma camada importar outra que não deveria, para que a arquitetura não dependa só de disciplina.
Gravar só o que a pessoa disse
O estado de uma decisão não é gravado, só a lista do que a pessoa declarou (a ordem dos critérios e cada resposta). Todo o resto é recalculado repetindo essa lista. Parece desperdício, mas foi uma das escolhas que mais renderam. Desfazer uma resposta vira cortar o fim da lista, respostas contraditórias aparecem como um problema de programação linear inviável, e trocar de problemática não obriga a perguntar tudo de novo.
Perguntar menos não era o objetivo
Testei um seletor de perguntas por ganho de informação que, num caso de ordenação, resolvia em 10 perguntas o que o oficial resolve em 21. O número parece ótimo, mas esse seletor afastava do oficial cinco casos que já batiam, e eu fiquei com o que reproduz o percurso do método. Os limites que decidem quando um par de critérios está esgotado também vieram de medições contra o oficial, e não do olho.
O assistente não decide nada
Com o servidor MCP, dá para conduzir uma decisão conversando com o Claude, mas o servidor só traduz o protocolo e não calcula nada por conta própria. O assistente é instruído a nunca responder pela pessoa, e a ferramenta de resposta exige o identificador da pergunta, para que nenhuma resposta seja registrada para uma pergunta que ninguém viu.
Três medições que mudaram o código
O solver. A API chama o HiGHS direto, com um solver por requisição e sem reaproveitar a base entre consultas, o que fazia a mesma decisão dar resultados diferentes. Com dezesseis conexões simultâneas, isso deu 56,8 requisições por segundo, contra 16,3 com o SciPy.
A fila. Cada cálculo pesado espera uma vaga antes de ocupar uma thread, com no máximo dois por pessoa e 24 no total. Sem isso, uma pessoa com várias decisões grandes podia travar as outras, e a verificação de saúde de outra pessoa chegou a passar de 5 milissegundos para 68 segundos.
A memória. As bibliotecas de álgebra linear abrem uma thread por núcleo. Fixar cada uma em uma thread só, com três variáveis de ambiente, derrubou a memória do processo de 1,5 GB para 124 MB.
Segurança
O FITradeoff morava atrás da FasorX, que cuidava do login e emitia um token de 5 minutos assinado com RS256. Sem emissor e público configurados, o processo nem subia, para que o estado perigoso, publicado e sem autenticação, não fosse alcançado por esquecimento. O diretório de cada pessoa é um resumo SHA-256 da identidade, e a parte exposta à internet é uma aplicação separada, só com o /mcp e a verificação de saúde.
As chaves dos assistentes têm 256 bits aleatórios, vencem em 90 dias e só o resumo delas fica guardado. Como são aleatórias, um KDF lento como o bcrypt só acrescentaria custo. Um scanner de segurança, o OWASP ZAP, também levou a interface a montar a própria CSP, com um nonce novo a cada requisição.
Como saber se está certo
Além da paridade com o oficial, há um teste-oráculo, em que um decisor simulado, com pesos escondidos, responde às perguntas, e o teste falha se o método descartar a alternativa que de fato é a melhor. Até a documentação é cobrada por teste, que falha se uma função relevante não disser o porquê, a fonte no método e se o resultado é exato ou aproximado.
Onde a versão nova fica devendo
Seria desonesto terminar sem esta parte. A versão nova não substitui o oficial. Tudo o que ela sabe do comportamento dele veio de observação, que cobre os casos testados, não todos os possíveis. Com acesso ao motor original, o caminho seria mantê-lo e trocar só o que está em volta dele.
A paridade também não é total. Dos 6 casos que não batem, 4 acontecem quando a primeira pergunta é respondida com B, situação em que o oficial às vezes repete o par anterior. Encontrei um padrão que reproduz esses quatro casos, mas não o implementei, porque não é uma regra que eu tenha entendido. Os outros 2 terminam com uma pergunta de diferença, num par que fica a menos de 0,00005 do limiar de parada.
A carteira combinatória do oficial não pôde ser comparada, porque o resultado dele nunca ficou acessível nos meus testes, e a versão nova a resolve por aproximação. Por fim, a versão nova ficou pouco tempo no ar, então não dá para afirmar que ela seria mais disponível ao longo de anos, só mostrar como ela foi montada para isso.
Se quiser rodar
O código está no repositório. Com Python 3.13 e Node.js instalados:
python -m venv engine/.venv
engine/.venv/Scripts/python -m pip install -e engine[dev] -e mcp_server -e api
cd web && npm install
No Windows, o .\iniciar.ps1 sobe a API em 127.0.0.1:8000 e a interface em localhost:3000. Os testes rodam com pytest engine/tests mcp_server/tests, e a suíte de paridade, sem rede, com python -m pytest paridade/. Para ir mais fundo, o repositório tem as lições de engenharia reversa, a paridade com o oficial e o comportamento medido, caso a caso.
Para fechar
O FITradeoff cumpriu o que eu queria dele. Reconstruído com uma stack de hoje, o mesmo método passou a rodar com HTTPS, com testes que o comparam ao original e com telas mais claras, chegando às mesmas conclusões em 67 dos 73 casos comparáveis. Por isso ele pôde sair do ar, e o código continua disponível. Se você usa o FITradeoff e quiser trocar uma ideia, me chama pelo contato.
O FITradeoff é uma implementação independente, sem vínculo com o grupo que criou o método, e pode apresentar valores diferentes do sistema oficial. Foi construída a partir do guia prático, dos artigos publicados e da observação do sistema oficial.