FITradeoff: el mismo método, con un stack de hoy
Resumen ejecutivo
- Por qué existe: el sistema oficial del método funciona, pero es antiguo. Hecho en Delphi, a veces se cuelga o se cae, y no usa HTTPS. Quise mostrar que un stack de hoy hace lo mismo de una forma más robusta, más confiable y más bonita.
- Qué es: una implementación independiente de FITradeoff, que apoya decisiones con varios criterios sin pedir pesos, solo con preguntas de compensación.
- Qué no es: un sustituto del oficial. Sin acceso al motor original, reconstruí su comportamiento mediante ingeniería inversa.
- Stack: Python con el solver HiGHS, FastAPI, Next.js y un servidor MCP, todo en Docker.
- Calidad: cerca de 1.675 pruebas, y resultado y secuencia de preguntas iguales a los del oficial en 67 de 73 casos comparables.
- Tiempo y costo: cerca de 60 horas, la mitad en ingeniería inversa, y cerca de US$ 1.600 a precio de API. No es lo que gasté, porque usé un plan de suscripción.
- Situación: FITradeoff salió del aire, y el código está en GitHub.
¿Te interesó el resumen? Entonces sigue adelante, el resto es para ti. Si no te interesó, puedes parar aquí sin culpa: lo esencial está arriba, y tu tiempo vale más que mi texto.
Cuánto costó, en horas y en tokens
Todo FITradeoff se construyó con Claude Code, que registra la hora de cada mensaje y los tokens gastados en cada respuesta. Con esos registros, medí el tiempo y el costo del proyecto.
El valor en dólares de esta sección no es lo que gasté. Usé un plan de suscripción, mucho más barato. El número muestra cuánto costaría el mismo trabajo pagando la API de Anthropic por uso, y es lo que más se acerca al costo real de construir algo así con IA.
El tiempo
Fueron cerca de 60 horas de trabajo en 11 días, con 256 pedidos. De esas horas, entre 9 y 19 fueron mías, leyendo respuestas y escribiendo pedidos; el resto del tiempo, el agente trabajó solo. Conté solo los tramos con actividad, sin las pausas de más de 10 minutos. Tolerando pausas de hasta 30 minutos, el total llega a cerca de 82 horas.
La ingeniería inversa se llevó la mitad de ese tiempo, cerca de 34 horas, frente a 8 de la construcción de funcionalidades. Para quien piense en hacer algo parecido, eso es lo que yo tendría en cuenta al planificar. Con un agente de código, implementar lo que describen los artículos avanza rápido, y lo que demora es hacer que el programa se comporte como un sistema que solo se ve desde afuera. Aquí fueron unas cuatro horas de comparación por cada hora de construcción, en un sistema de cinco módulos y 74 casos comparados. No es una regla, y en un sistema más grande o menos documentado la comparación probablemente pese aún más.
Adónde fueron el tiempo y el dinero
Por tipo de trabajo, los pedidos se repartieron así.
| Lo que estaba pidiendo | Pedidos | Tiempo | Costo (API) |
|---|---|---|---|
| Comparación con el sistema oficial | 94 | ~34 h | US$ 641 |
| Ajustes y correcciones, incluidas revisiones de código | 55 | ~14 h | US$ 448 |
| Construcción de funcionalidades | 41 | ~8 h | US$ 194 |
| Despliegue, infraestructura y seguridad | 46 | ~7 h | US$ 187 |
| Documentación | 10 | ~2 h | US$ 59 |
| Entorno y herramientas | 6 | ~1 h | US$ 33 |
| Sin tema definido | 4 | ~2 h | US$ 36 |
| Total | 256 | ~68 h | ≈ US$ 1.600 |
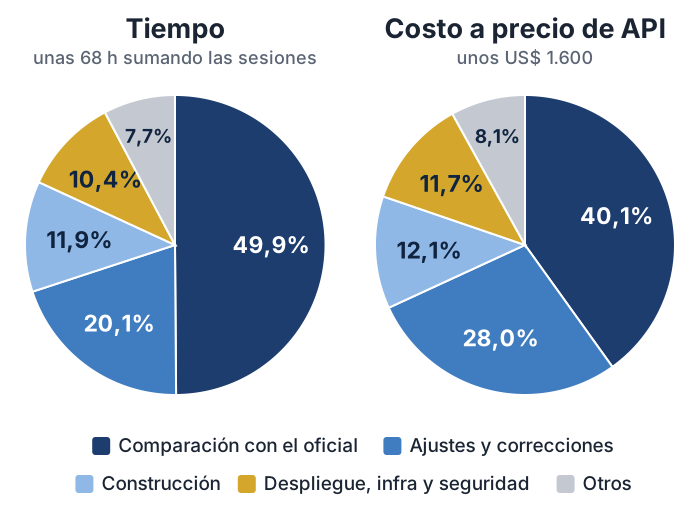
La comparación con el oficial se llevó la mitad del tiempo y cerca del 40% del costo, casi lo mismo que construcción y ajustes juntos. La sección "Los artículos no alcanzaron", más abajo, explica por qué.
Los tokens
Fueron cerca de 3.000 millones de tokens, el 98,7% de ellos lecturas de caché, porque en cada respuesta el modelo vuelve a leer toda la conversación. Esa relectura cuesta una fracción del precio normal y, aun así, se quedó con cerca del 74% de la cuenta. El texto que el modelo realmente escribió, código incluido, sumó apenas 6,5 millones de tokens. Casi todo corrió en Claude Opus 5 y en Opus 5.5.
Cómo llegué a estos números
Los precios son los de la tabla que el propio Claude Code usa en el comando /cost, la misma de la API (Opus 5, por ejemplo, cuesta US$ 5 por millón de tokens de entrada y US$ 25 por millón de salida). En una sesión completa, mi cuenta quedó un 4% por debajo de la de Claude Code, así que conviene un margen de un 5%. Los pedidos se clasificaron a mano, y quedaron fuera las conversaciones en claude.ai y los pedidos de otros proyectos.
Por qué rehacer algo que ya existe
FITradeoff ya existía. El grupo que creó el método, en el CDSID de la UFPE, en Brasil, mantiene un sistema oficial usado en investigación, y el mérito del método es todo de sus autores. Lo que yo quería poner a prueba era el stack.
El sistema oficial es de otra generación de software. Hecho en Delphi, con el framework IntraWeb, a veces se cuelga en medio de una sesión, y durante mis pruebas se cayó varias veces, durante horas. Se sirve sin HTTPS, así que el inicio de sesión y los datos de las decisiones viajan sin cifrar. Las pantallas existen solo en inglés, con un aviso para no usar la traducción automática del navegador, y los criterios aparecen como C1, C2 y C3. Nada de esto es un defecto del método, sino de la época en que se hizo el software.
La pregunta, entonces, era si el mismo método, construido con las herramientas de hoy, se convertiría en un programa más robusto, más confiable y más bonito. Para que la respuesta valiera, no podía tocar el método, y por eso nada se daba por terminado antes de pasar por la comparación con el oficial.
El problema de los pesos
En ingeniería es común decidir entre alternativas evaluadas con varios criterios, y la herramienta más usada es la suma ponderada. Su problema está en los pesos. Es difícil afirmar con seguridad que el costo vale 0,35 y el plazo 0,20, y muchas veces ese número sale de una corazonada de la que pasa a depender toda la conclusión.
FITradeoff, propuesto por Adiel de Almeida y colegas en 2016, cambia la pregunta sobre pesos por comparaciones entre dos situaciones concretas, en unidades reales, y hace solo las preguntas que necesita.
Cómo funciona el método, sin fórmulas
La persona empieza ordenando los criterios, del más al menos importante, lo que ya reduce el espacio de pesos posibles. Después vienen las preguntas de compensación, en las que el sistema muestra dos consecuencias hipotéticas y pregunta cuál prefiere. Por detrás, cada respuesta es un paso de una búsqueda binaria sobre la razón entre dos pesos.
Con cada respuesta, el sistema verifica, con programación lineal, qué alternativas todavía pueden ser la mejor con algún conjunto de pesos compatible con todo lo dicho. Cuando queda una sola, o cuando las que quedan son prácticamente equivalentes, las preguntas terminan. La implementación cubre las cinco problemáticas del oficial (elección, ordenación, clasificación, cartera y beneficio por costo). La elección es exacta, y la cartera, aproximada.
Los artículos no alcanzaron
Empecé por el artículo de 2016, por la guía del usuario y por otros trabajos del grupo. Explican bien el método, pero no las reglas que hacen que el programa se comporte como se comporta, como la pregunta que abre la sesión, el orden de los pares de criterios y el momento de parar. Sin esas reglas, una implementación fiel a los artículos puede llegar al mismo resultado por otro camino, y entonces ya no es el mismo programa.
La salida fue la ingeniería inversa. Escribí un robot con Playwright que corre los mismos casos en el oficial y en la nueva versión y los compara pregunta por pregunta, y así aparecieron las reglas ocultas. En un criterio discreto, como una nota de 1 a 5, el oficial solo pregunta en el tercio, en el medio y en los dos tercios entre dos niveles, mientras que mi versión hacía una búsqueda continua. Hicieron falta cinco rondas para cerrar esa regla.
El robot fue un proyecto aparte, porque el oficial rechazaba navegadores automatizados, tenía botones que desaparecían en medio del clic y sesiones que se colgaban durante horas. Por eso cada medición quedó guardada, y la suite de paridad corre sin red. Algunos puntos, como la fórmula del modelo de veto, no pudieron confirmarse y están registrados como inferencia.
Las dos versiones, lado a lado
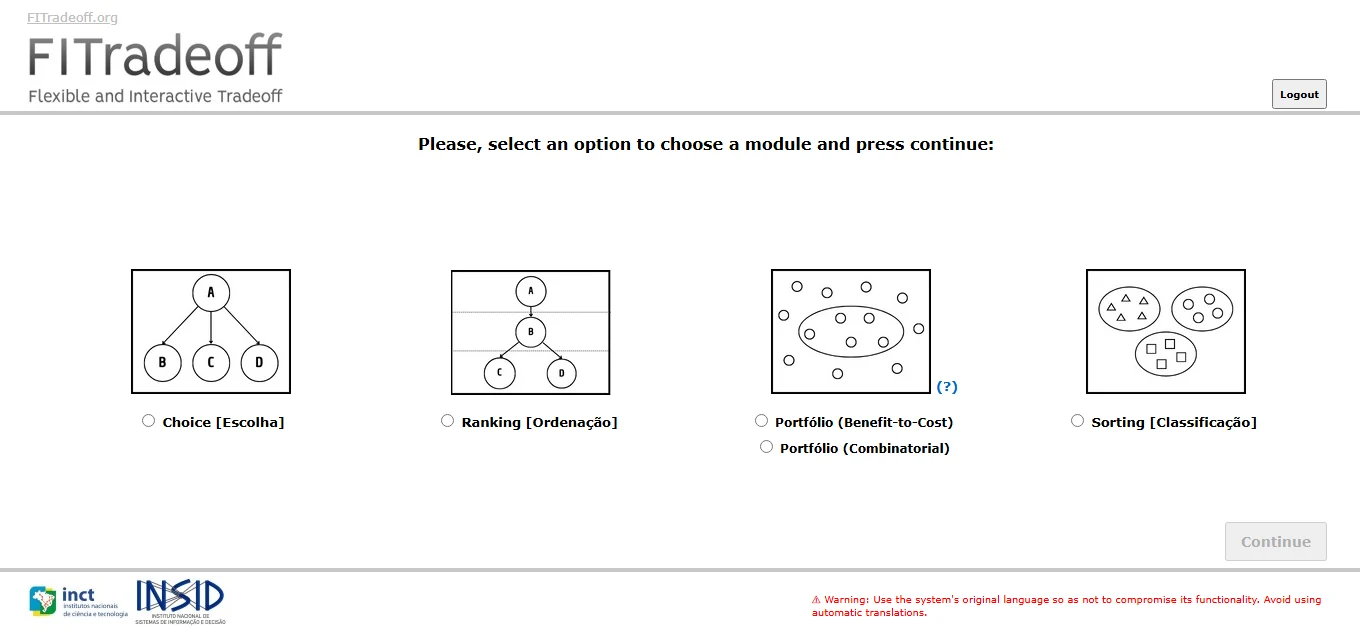
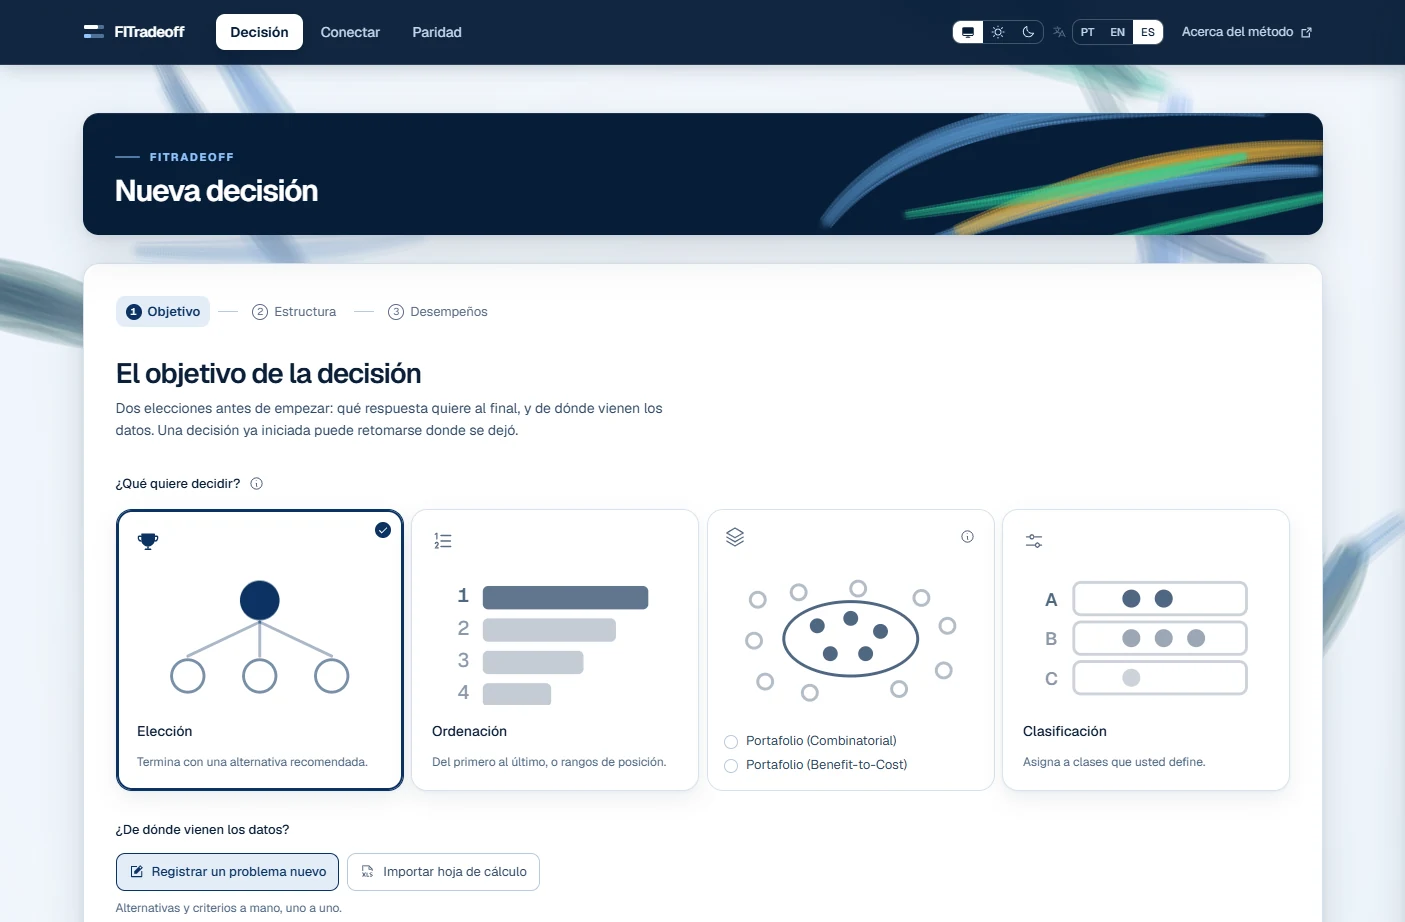
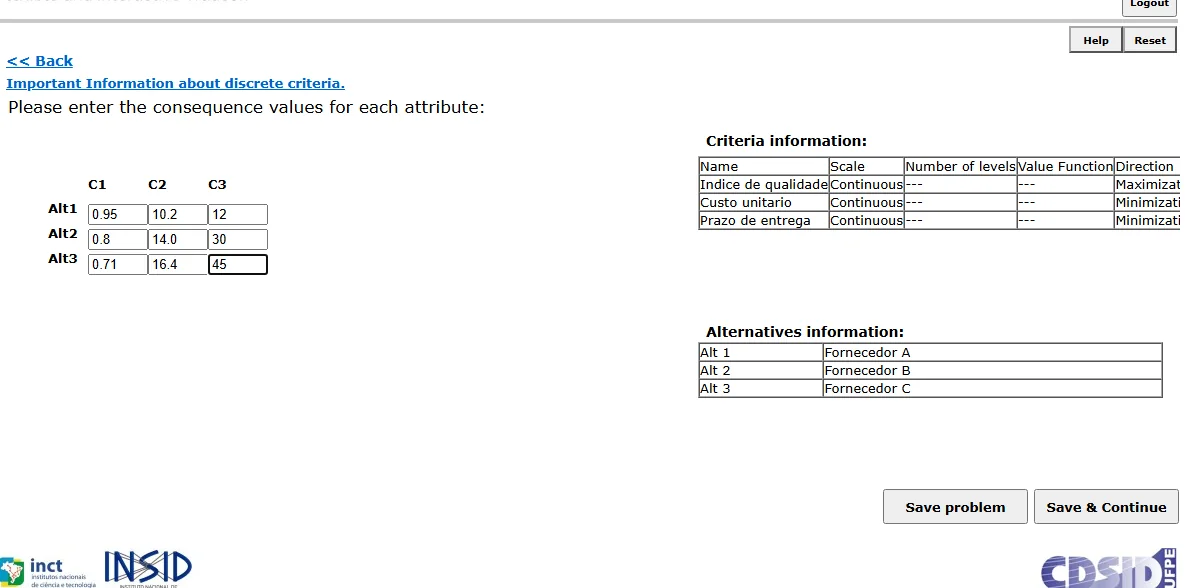
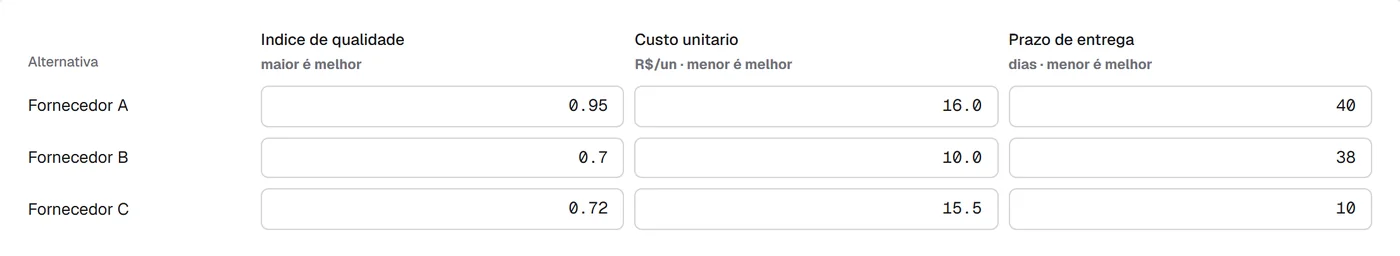
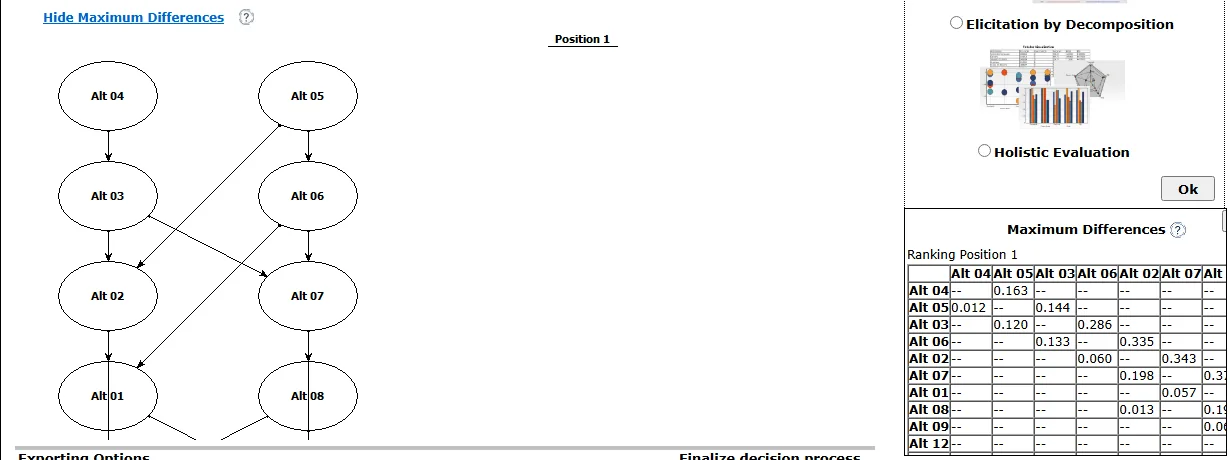
Las imágenes de abajo muestran las mismas etapas en los dos sistemas, con el oficial arriba. Las capturas del oficial son de FITradeoff.org, del CDSID/UFPE, y están aquí solo para comparar.
La pantalla inicial
Las dos pantallas ofrecen las mismas opciones, incluidas las dos variantes de cartera. En el oficial, los módulos aparecen con el nombre en inglés y la traducción al portugués entre corchetes, y solo la cartera tiene un botón de ayuda. En la nueva versión, cada tarjeta dice en qué termina esa decisión, los pasos siguientes aparecen arriba y el origen de los datos, a mano o por planilla, se elige ahí mismo.
Matriz de desempeños
Pregunta de compensación
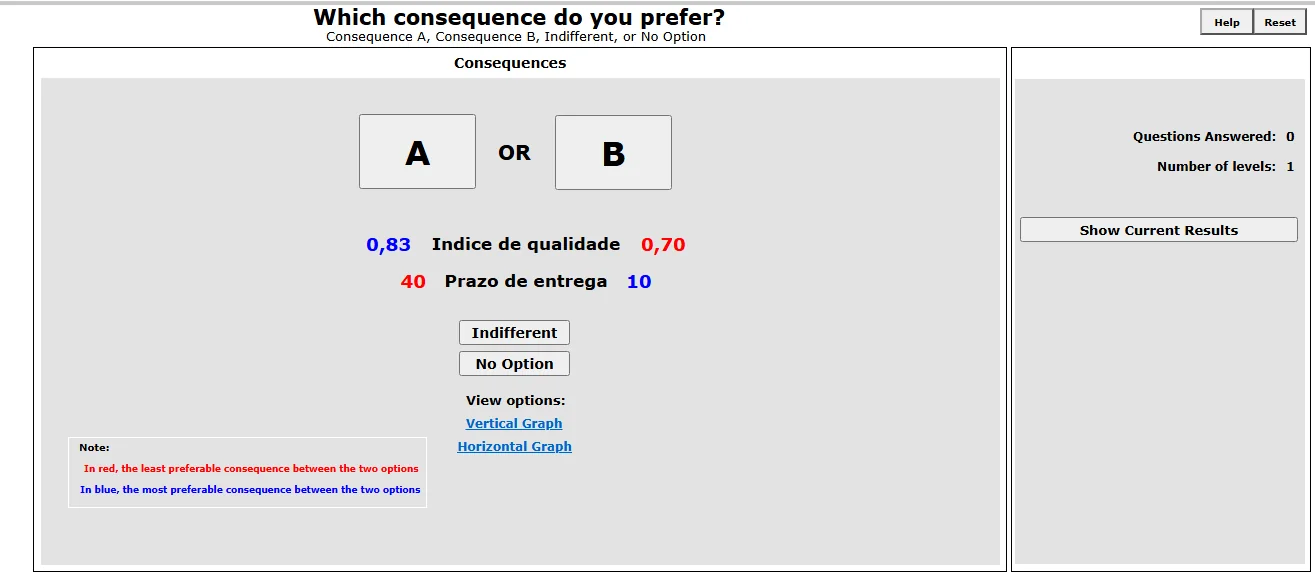
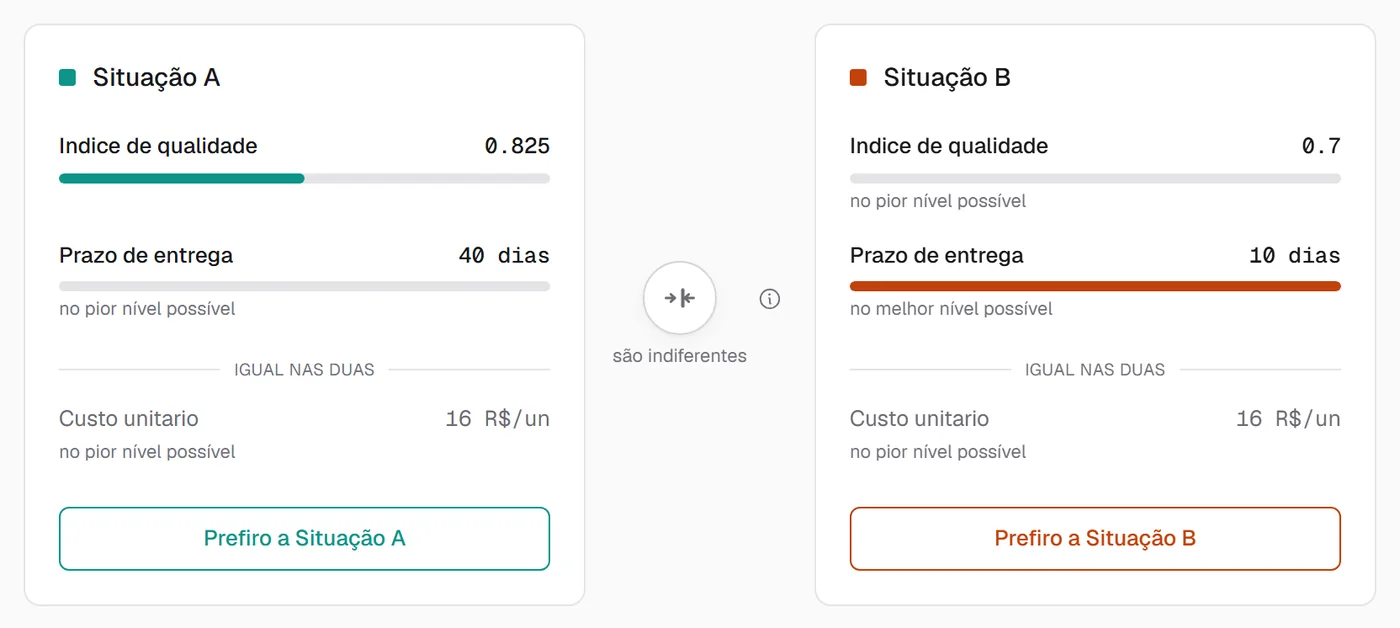
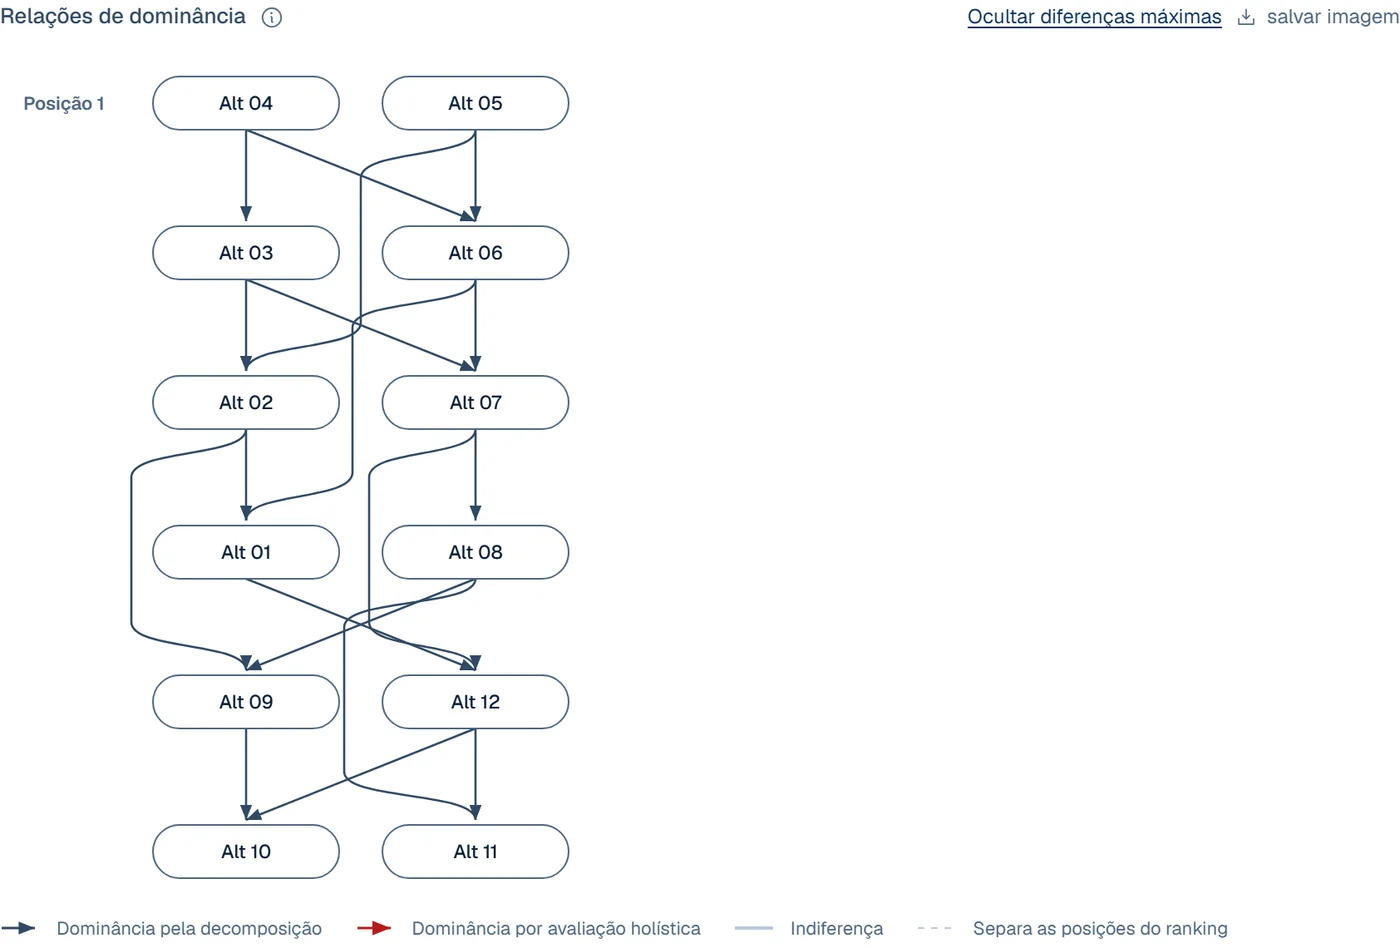
Diagrama de Hasse
Cuando el orden todavía no se cerró, los dos sistemas dibujan qué alternativa nunca queda detrás de cuál. En el caso comparado, los pares de dominancia salen iguales en los dos.
El stack
El repositorio tiene cinco partes: el motor (engine/), la API (api/), el servidor MCP (mcp_server/), la interfaz (web/) y la suite de paridad (paridade/). El motor usa Python 3.13, NumPy, SciPy y el solver HiGHS, la API usa FastAPI y la interfaz usa Next.js 15, React 19, TypeScript y Tailwind. Todo corre en contenedores Docker endurecidos, que se reinician solos, detrás de un Caddy con HTTPS, y el despliegue con GitHub Actions vuelve a la versión anterior si la subida falla. Una prueba además lee el código del motor y falla si una capa importa otra que no debería, para que la arquitectura no dependa solo de la disciplina.
Guardar solo lo que la persona dijo
El estado de una decisión no se guarda, solo la lista de lo que la persona declaró (el orden de los criterios y cada respuesta). Todo lo demás se recalcula repitiendo esa lista. Parece un desperdicio, pero fue una de las decisiones que más rindieron. Deshacer una respuesta se reduce a cortar el final de la lista, las respuestas contradictorias aparecen como un problema de programación lineal inviable, y cambiar de problemática no obliga a preguntar todo de nuevo.
Preguntar menos no era el objetivo
Probé un selector de preguntas por ganancia de información que, en un caso de ordenación, resolvía en 10 preguntas lo que el oficial resuelve en 21. El número parece excelente, pero ese selector alejaba del oficial cinco casos que ya coincidían, y me quedé con el que reproduce el recorrido del método. Los umbrales que deciden cuándo un par de criterios está agotado también salieron de mediciones contra el oficial, y no a ojo.
El asistente no decide nada
Con el servidor MCP se puede llevar una decisión conversando con Claude, pero el servidor solo traduce el protocolo y no calcula nada por su cuenta. El asistente tiene instrucciones de nunca responder por la persona, y la herramienta de respuesta exige el identificador de la pregunta, para que no se registre ninguna respuesta a una pregunta que nadie vio.
Tres mediciones que cambiaron el código
El solver. La API llama a HiGHS directamente, con un solver por solicitud y sin reutilizar la base entre consultas, lo que hacía que la misma decisión diera resultados distintos. Con dieciséis conexiones simultáneas, eso dio 56,8 solicitudes por segundo, frente a 16,3 con SciPy.
La cola. Cada cálculo pesado espera un lugar antes de ocupar un hilo, con un máximo de dos por persona y 24 en total. Sin eso, una persona con varias decisiones grandes podía trabar a las demás, y la verificación de salud de otra persona llegó a pasar de 5 milisegundos a 68 segundos.
La memoria. Las bibliotecas de álgebra lineal abren un hilo por núcleo. Fijar cada una en un solo hilo, con tres variables de entorno, bajó la memoria del proceso de 1,5 GB a 124 MB.
Seguridad
FITradeoff vivía detrás de FasorX, que se encargaba del inicio de sesión y emitía un token de 5 minutos firmado con RS256. Sin el emisor y la audiencia configurados, el proceso ni siquiera arrancaba, para que el estado peligroso, publicado y sin autenticación, no se alcanzara por olvido. El directorio de cada persona es un resumen SHA-256 de su identidad, y la parte expuesta a internet es una aplicación aparte, solo con /mcp y la verificación de salud.
Las claves de los asistentes tienen 256 bits aleatorios, vencen en 90 días y solo se guarda su resumen. Como son aleatorias, un KDF lento como bcrypt solo agregaría costo. Un escáner de seguridad, OWASP ZAP, también llevó a la interfaz a armar su propia CSP, con un nonce nuevo en cada solicitud.
Cómo saber si está bien
Además de la paridad con el oficial, hay una prueba oráculo, en la que un decisor simulado, con pesos ocultos, responde las preguntas, y la prueba falla si el método descarta la alternativa que de verdad es la mejor. Hasta la documentación está cubierta por una prueba, que falla si una función relevante no dice el porqué, la fuente en el método y si el resultado es exacto o aproximado.
En qué se queda corta la nueva versión
Sería deshonesto terminar sin esta parte. La nueva versión no sustituye al oficial. Todo lo que sabe de su comportamiento salió de la observación, que cubre los casos probados, no todos los posibles. Con acceso al motor original, el camino sería mantenerlo y cambiar solo lo que lo rodea.
La paridad tampoco es total. De los 6 casos que no coinciden, 4 ocurren cuando la primera pregunta se responde con B, situación en la que el oficial a veces repite el par anterior. Encontré un patrón que reproduce esos cuatro casos, pero no lo implementé, porque no es una regla que haya entendido. Los otros 2 terminan con una pregunta de diferencia, en un par que queda a menos de 0,00005 del umbral de parada.
La cartera combinatoria del oficial no pudo compararse, porque su resultado nunca quedó disponible en mis pruebas, y la nueva versión la resuelve de forma aproximada. Por último, la nueva versión estuvo poco tiempo en línea, así que no puedo afirmar que sería más disponible a lo largo de los años, solo mostrar cómo se armó para eso.
Si quieres correrlo
El código está en el repositorio. Con Python 3.13 y Node.js instalados:
python -m venv engine/.venv
engine/.venv/Scripts/python -m pip install -e engine[dev] -e mcp_server -e api
cd web && npm install
En Windows, .\iniciar.ps1 levanta la API en 127.0.0.1:8000 y la interfaz en localhost:3000. Las pruebas corren con pytest engine/tests mcp_server/tests, y la suite de paridad, sin red, con python -m pytest paridade/. Para ir más a fondo, el repositorio tiene las lecciones de ingeniería inversa, la paridad con el oficial y el comportamiento medido, caso por caso, todo en portugués.
Para cerrar
FITradeoff cumplió lo que yo quería de él. Reconstruido con un stack de hoy, el mismo método pasó a correr con HTTPS, con pruebas que lo comparan con el original y con pantallas más claras, y llegó a las mismas conclusiones en 67 de 73 casos comparables. Por eso pudo salir del aire, y el código sigue disponible. Si usas FITradeoff y quieres conversar sobre esto, escríbeme por la página de contacto.
Este FITradeoff es una implementación independiente, sin vínculo con el grupo que creó el método, y puede presentar valores distintos de los del sistema oficial. Se construyó a partir de la guía práctica, de los artículos publicados y de la observación del sistema oficial.